HBM4의 큰 변화는 한 스택의 데이터폭이 1,024bit에서 2,048bit로 넓어진다는 점이에요. 더 넓고 빠른 입출력을 다루는 베이스 다이도 중요해집니다. 저장 용량은 별도로 확인해야 해요.
이전 편에서는 같은 D램 칩을 더 쌓을 때 용량이 어떻게 늘어나는지 봤습니다. 이번에는 같은 12단·36GB라도 세대가 바뀌면 무엇이 달라지는지 살펴볼게요. HBM은 여러 D램 칩을 쌓아 GPU 가까이에서 데이터를 공급하는 고대역폭 메모리입니다.
| 비교 항목 | HBM3E | HBM4 |
|---|---|---|
| 스택 외부 데이터폭 | 1,024bit | 2,048bit |
| 핀당 전송률을 같게 두면 | 기준 대역폭 | 이론 대역폭 2배 |
| 저장 용량 | 다이당 용량 × 적층 수 | 같은 방식으로 계산 |
| 베이스 다이 | 기존에도 있음 | 넓은 입출력·신호·전력 설계와 구현이 더 중요 |
이 표의 ‘2배’는 핀당 전송률을 같게 둔 계산입니다. 실제 제품의 대역폭과 GPU의 작업 속도는 아래처럼 조건을 구분해서 읽어야 해요. 데이터폭은 Micron HBM3E의 1,024 I/O 설명과 HBM4의 2,048 I/O 설명을 참고했습니다.
먼저 ‘데이터폭만 비교’를 선택해 보세요. 두 세대의 핀당 전송률은 같고, 데이터가 드나드는 통로 묶음만 두 배가 됩니다.
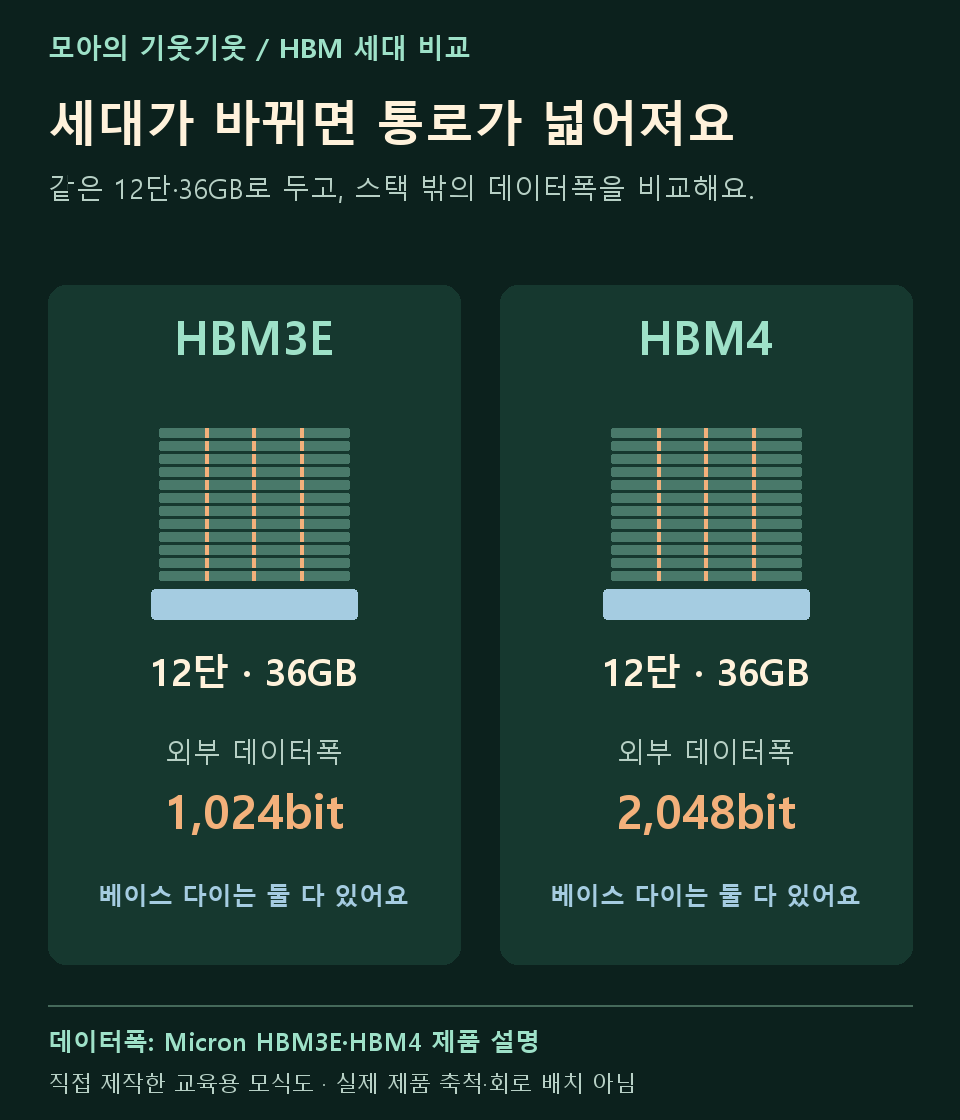
그림 1. 두 스택의 층수를 같게 그렸어요. 아래 파란색 베이스 다이는 두 세대 모두 있습니다. 제품의 실제 크기·높이·배선 수를 재현한 그림은 아닙니다.
1. 데이터폭은 ‘한 번에 나란히 옮기는 통로의 폭’
비슷한 속도로 움직이는 계산대가 여러 개 있다고 생각해 보세요. 계산대 하나의 처리 속도가 같아도, 계산대를 두 배로 늘리면 함께 처리할 수 있는 양이 늘어납니다.
HBM의 데이터폭은 바깥과 데이터를 주고받는 인터페이스의 폭이에요. HBM3E는 1,024bit, HBM4는 2,048bit입니다. 여기서 말하는 숫자는 데이터 입출력 폭이며, 전원·접지·명령 신호 등을 포함한 패키지 전체 접점 수가 아닙니다.
또한 2,048bit는 스택 전체의 외부 데이터폭이에요. 12단이라고 여기에 12를 다시 곱하지 않습니다. 단수와 세대의 차이는 HBM 8단·12단·16단 편과 연결해서 보면 이해하기 쉬워요.
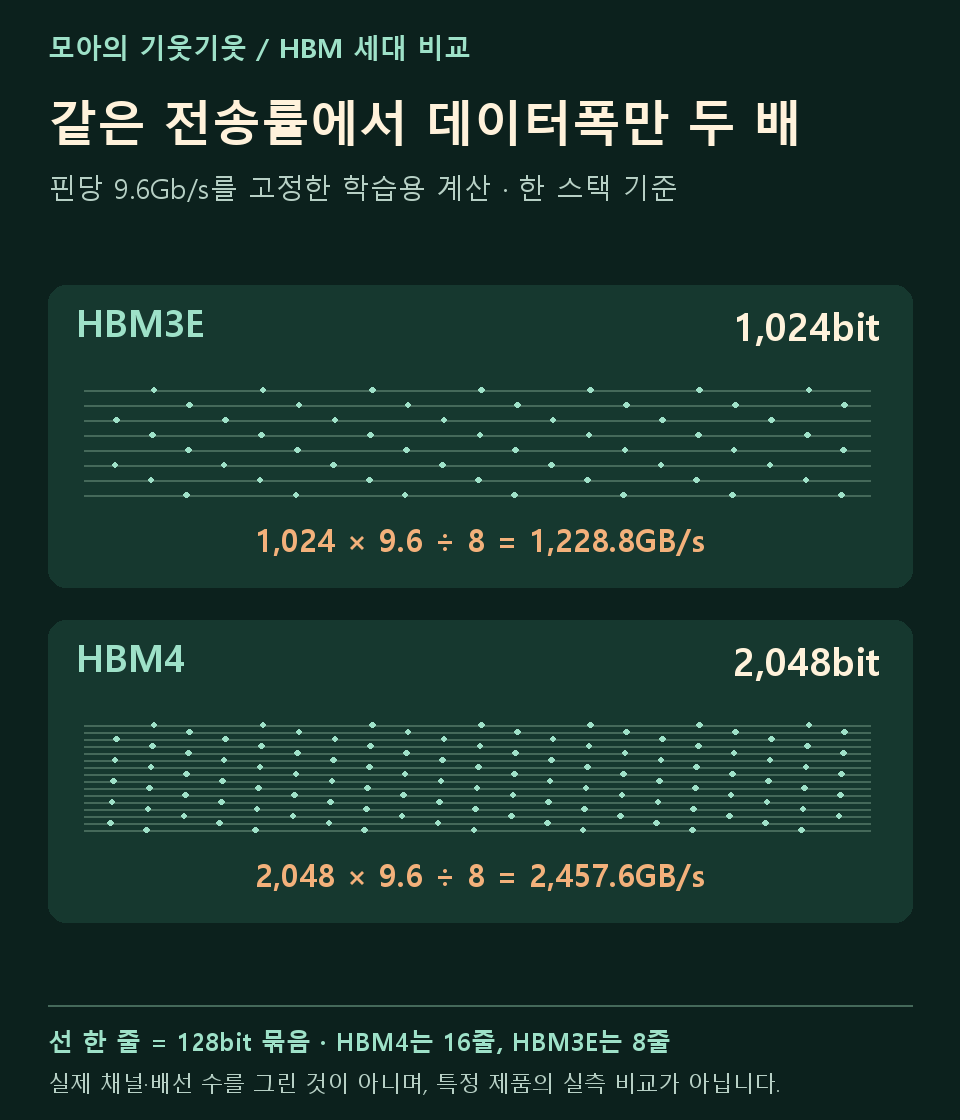
그림 2. 그림의 선 하나는 128bit를 묶어 표현했어요. 실제 채널·배선 한 가닥과 일대일로 대응시키지는 않습니다. 같은 전송률에서 HBM4 쪽 통로 묶음이 두 배입니다.
2. 대역폭은 데이터폭과 핀당 전송률을 함께 계산해요
이론적 최대 대역폭(GB/s) = 데이터폭(bit) × 핀당 전송률(Gb/s) ÷ 8
8비트가 1바이트이므로 8로 나눕니다. 여기서 핀당 전송률은 초당 전달하는 비트 수예요. 숫자만 보고 실제 신호의 이동 속도나 GPU의 연산 속도로 읽으면 안 됩니다.
핀당 전송률을 둘 다 9.6Gb/s로 고정하면 다음과 같아요.
• HBM3E: 1,024 × 9.6 ÷ 8 = 1,228.8GB/s
• HBM4: 2,048 × 9.6 ÷ 8 = 2,457.6GB/s
통로 폭만 두 배이므로 이론 대역폭도 정확히 두 배입니다. 이 비교는 구조의 효과를 떼어 보는 학습용 계산이며, 두 세대의 특정 제품을 그대로 짝지은 성능표는 아니에요. 9.6Gb/s는 아래 삼성 발표의 HBM3E 핀당 전송률 사례에서 가져온 비교 조건입니다.
3. 실제 수치에서는 11.7Gb/s와 최대 13Gb/s를 구분해요
삼성전자는 2026년 2월 12일 HBM4 양산 출하 발표에서 안정적으로 확보한 전송률을 11.7Gb/s, 구현 가능한 최대 전송률을 13Gb/s로 설명했습니다. 이전 HBM3E의 최대 핀당 전송률은 9.6Gb/s로 비교했어요. 출처: 삼성 HBM4 양산 출하 발표
이 발표의 입력값으로 계산하면 다음처럼 조건이 나뉩니다.
| 구분 | 데이터폭 | 핀당 전송률 | 이론 대역폭 계산 |
|---|---|---|---|
| HBM3E 비교 기준 | 1,024bit | 9.6Gb/s | 1,228.8GB/s |
| HBM4의 11.7Gb/s 조건 | 2,048bit | 11.7Gb/s | 2,995.2GB/s, 약 3.00TB/s |
| HBM4의 최대 13Gb/s 조건 | 2,048bit | 13.0Gb/s | 3,328GB/s, 약 3.33TB/s |
11.7Gb/s에 ‘최대 3.3TB/s’를 그대로 붙이면 계산 조건이 맞지 않아요. 발표의 최대 3.3TB/s는 최대 전송률 조건과 함께 읽어야 합니다. 위의 소수점 수치는 공식 입력값으로 직접 계산한 이론값이며, 제조사가 공표한 실측 결과로 제시한 것은 아닙니다.
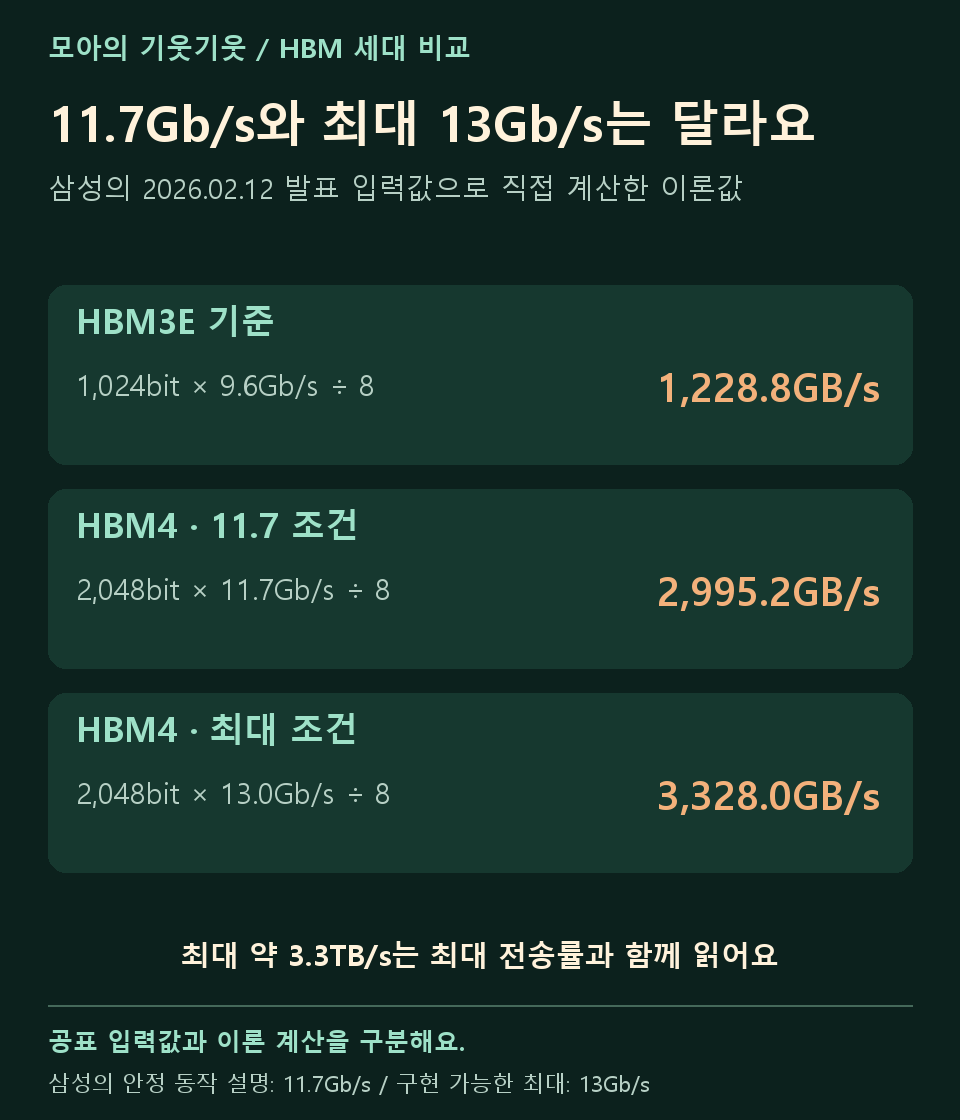
그림 3. HBM4의 11.7Gb/s 조건은 위 HBM3E 기준의 약 2.44배, 최대 13Gb/s 조건은 약 2.71배로 계산됩니다. 모두 한 스택의 이론 대역폭 비교예요.
삼성이 당시 발표에서 비교한 업계 표준 전송률은 8Gb/s였고, 실제 제품은 이를 웃도는 수치를 제시했습니다. 따라서 표준을 소개하는 수치와 제조사의 제품·최대 동작 조건을 섞지 않는 것이 중요합니다. 현재 제품 페이지도 HBM4를 2,048 I/O·최대 13Gb/s로 소개합니다. 출처: 삼성 HBM 제품 페이지
4. 베이스 다이는 무엇을 하는 칩일까?
위쪽 D램 다이가 데이터를 저장하는 층이라면, 베이스 다이는 스택 맨 아래에서 메모리 층과 외부 시스템을 연결하는 기반 칩이에요. 입출력 회로와 신호·전력 제어 등을 다룹니다. GPU 쪽의 연산부와 메모리 제어 회로도 함께 연결되어 시스템을 이룹니다. 베이스 다이의 위치와 연결 역할: SK하이닉스 설명
HBM3E에도 베이스 다이가 있습니다. SK하이닉스는 2024년 협력 발표에서 HBM3E까지 자체 기술로 베이스 다이를 만들었고, HBM4부터 TSMC의 로직 공정을 채택할 계획이라고 설명했어요. 2026년 기술 심포지엄 자료에서는 HBM4 베이스 다이에 TSMC의 첨단 로직 공정을 적용하는 방향을 다시 소개했습니다. 2024년 협력 발표, 2026년 심포지엄 설명
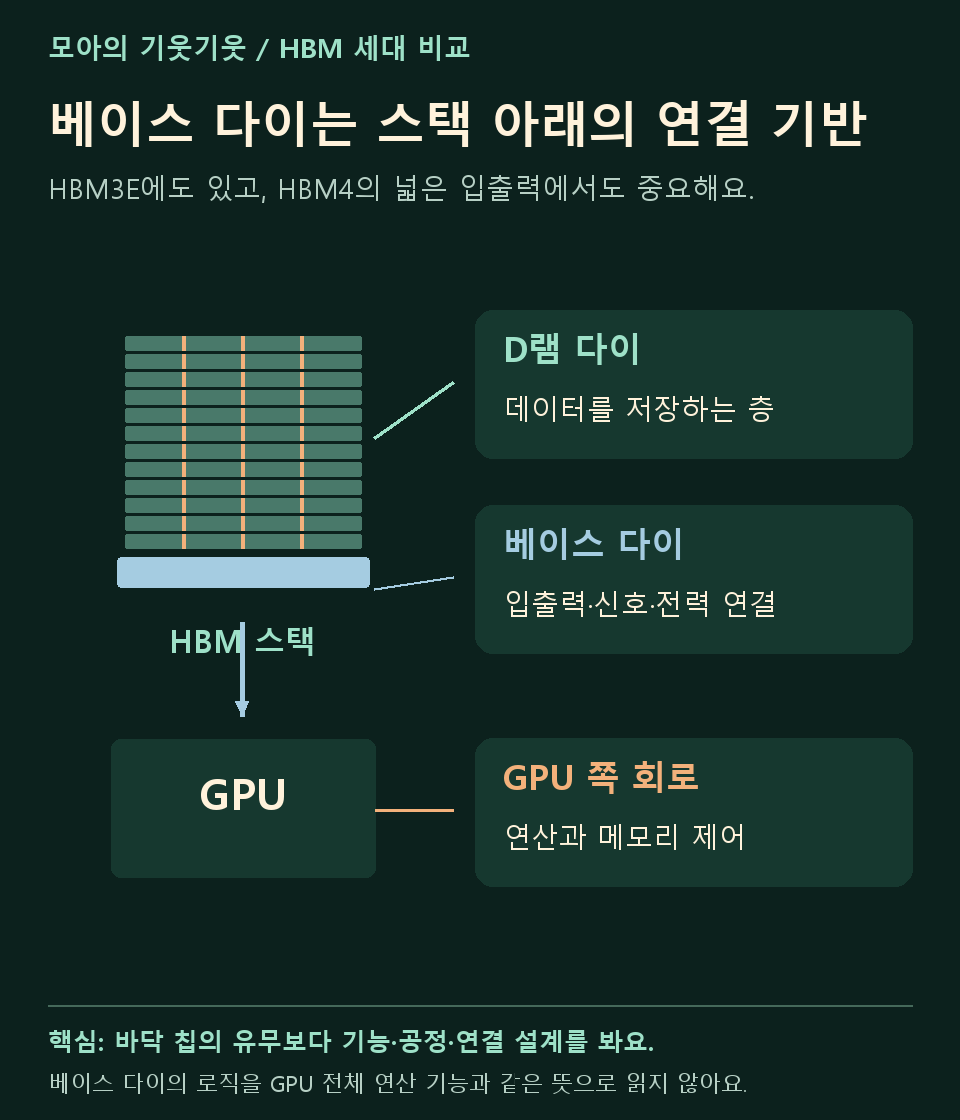
그림 4. ‘베이스 다이가 중요해졌다’는 말을 ‘HBM4부터 바닥 칩이 생겼다’로 이해하면 안 돼요. 그림의 블록은 기능을 설명하기 위한 구분이며, 실제 회로 배치도는 아닙니다.
입출력 폭이 넓어지면 더 많은 데이터 경로를 안정적으로 연결하고, 신호 품질·전력·열을 함께 관리해야 합니다. 첨단 로직 공정은 이런 회로를 설계하는 선택지를 넓혀 줍니다. 이것은 메모리를 GPU로 바꾼다는 뜻도, 모든 HBM4가 특정 AI 연산 기능을 내장한다는 뜻도 아닙니다.
5. HBM4의 베이스 다이는 모두 같은 공정일까?
제조사별 공식 자료를 보면 구현 방법이 다릅니다.
• 삼성전자: HBM4에 1c D램과 4nm 로직 베이스 다이를 적용했다고 발표했습니다. 위쪽 저장 칩의 D램 공정과 아래쪽 로직 칩의 공정을 나눠 읽어야 합니다. 2026년 2월 발표
• SK하이닉스: HBM4부터 TSMC의 첨단 로직 공정을 베이스 다이에 적용하는 협력을 소개합니다. 2026년 4월 발표
• Micron: HBM4에 자체 개발·제조한 CMOS 로직 베이스 다이를 사용한다고 설명했습니다. 2025년 6월 실적 자료, 10쪽
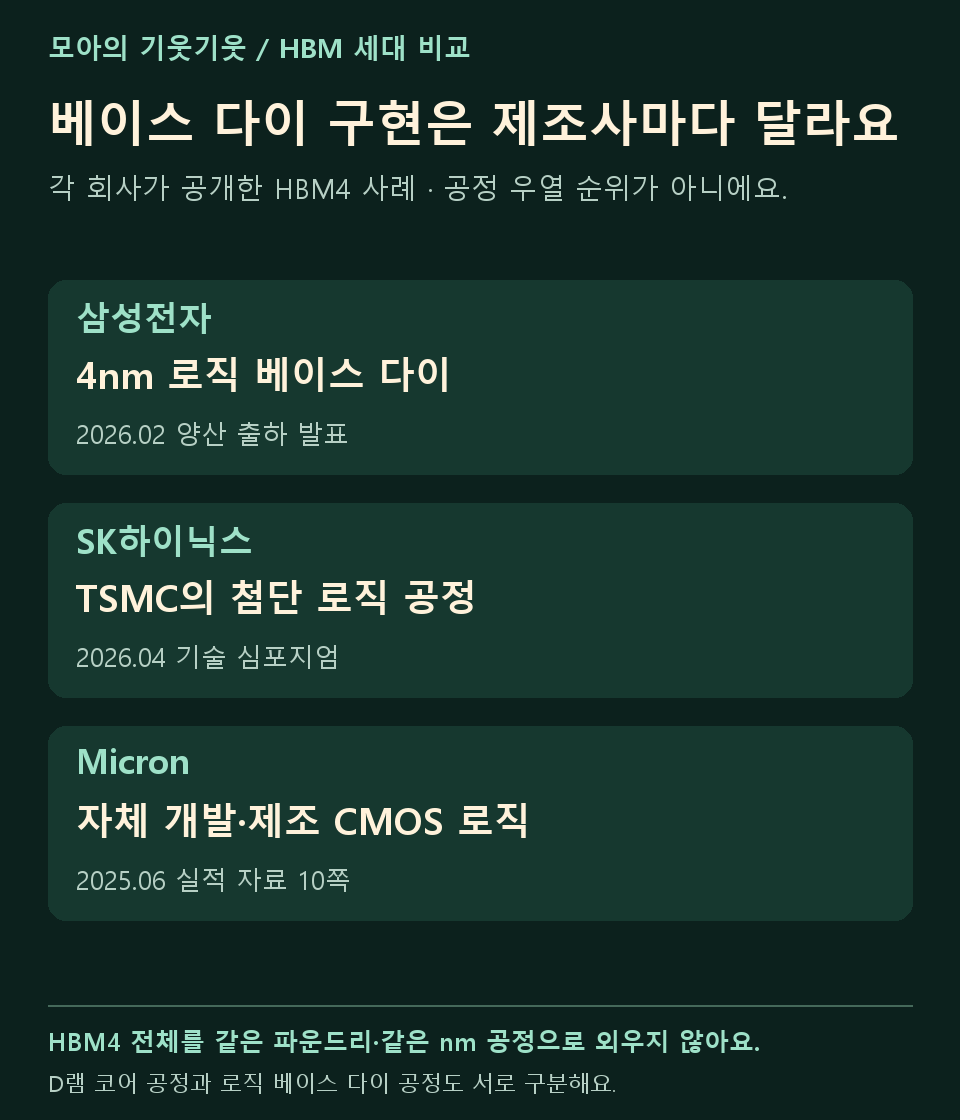
그림 5. 각 회사가 공개한 구현 사례이며 공정 우열 순위가 아니에요. ‘HBM4는 모두 같은 파운드리·같은 nm 공정’으로 외우면 부정확합니다. 공정 이름만으로 대역폭 배율을 계산할 수도 없습니다.
고객 요구에 맞춰 베이스 다이 등을 설계하는 Custom HBM도 별도의 제품·설계 방향입니다. HBM4라는 세대 이름만 보고 모든 제품을 고객 맞춤형으로 단정하지는 마세요.
6. 대역폭이 커지면 용량과 AI 성능도 같은 비율로 늘까?
용량은 여전히 다이 한 장의 용량 × 메모리 적층 수로 계산해요. 한 장이 3GB이고 12장을 쌓으면 두 세대 모두 36GB를 구성할 수 있습니다.
실제로 Micron은 HBM3E 12H와 HBM4 12H에 모두 36GB 용량을 소개합니다. 2026년 3월 16일 발표의 HBM4는 2.8TB/s 초과, 같은 36GB·12H의 HBM3E 대비 대역폭 2.3배라고 설명했어요. 이 비교는 해당 제조사의 공표치이며 단수나 용량이 두 배가 된 사례가 아닙니다. HBM3E 제품 설명, HBM4 발표 본문·주석 1
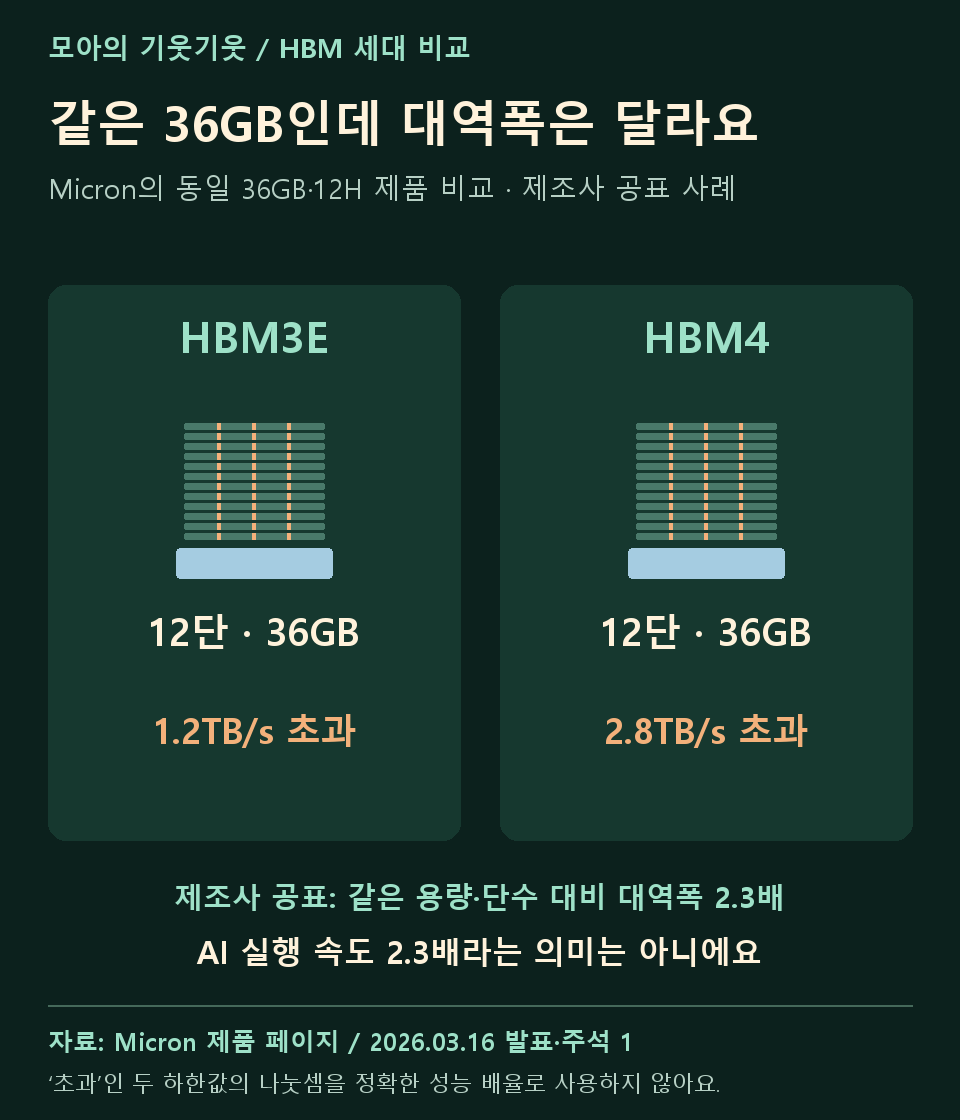
그림 6. 두 하한값인 1.2와 2.8을 나눠 정확한 성능 배율로 만들지 않았어요. ‘2.3배’는 제조사가 같은 용량·단수의 제품을 비교해 공표한 수치입니다.
GPU가 메모리에서 데이터를 공급받느라 기다리던 작업이라면 대역폭 확대가 도움이 될 수 있습니다. 반면 계산 능력이 병목이거나 데이터 재사용·병렬 처리 조건이 다르면 속도 향상도 달라져요. 대역폭 2배를 AI 실행 속도 2배로 바꿔 말할 수는 없습니다. 출처: NVIDIA GPU 성능 제한 요인 설명
7. 애니메이션으로 세 조건을 비교해 보세요
‘데이터폭만 비교’에서는 9.6Gb/s를 같게 두고 1,024bit와 2,048bit의 차이를 봅니다. 이어서 ‘11.7Gb/s 예’와 ‘13Gb/s 최대 예’를 선택해 전송률까지 달라질 때를 비교해 보세요.
아래의 전송률 조절기를 움직이면 공식에 따라 숫자가 다시 계산됩니다. 조절 범위의 모든 값이 실제 판매 제품의 동작 조건을 뜻하지는 않습니다. 두 스택의 용량은 12단·3GB 다이, 즉 36GB로 고정했어요.
점은 가상의 데이터 묶음입니다. 점의 이동 속도는 같고, 통로가 넓으면 줄 수가 늘고, 핀당 전송률이 높으면 점을 보내는 간격이 짧아집니다. 실제 전기 신호나 실측 작업 속도를 재현한 것은 아닙니다.
8. 56초로 복습하기
56초 · 직접 제작한 자막 애니메이션 · 음성 없음
HBM4를 볼 때는 통로의 폭, 통로당 전송률, 이를 연결하는 베이스 다이, 저장 용량을 나눠 확인해 보세요. 세대 이름 뒤에 붙는 숫자가 구체적으로 무엇을 바꿨는지 읽기가 쉬워집니다.
처음이라면 HBM 기초 편 → 8·12·16단과 용량 편 → 이번 편 순서로 읽어 보세요. 만드는 방법은 전공정·후공정 총정리에서 이어 볼 수 있습니다.
자료 확인: 2026년 11월 19일. 계산은 한 스택·십진 GB/s 기준입니다. 그림 6장과 영상은 직접 제작한 교육용 모식도이며, 제품 공표치·발표 시점·고정 조건의 계산을 구분했습니다.
#HBM #HBM3E #HBM4 #고대역폭메모리 #데이터폭 #메모리대역폭 #베이스다이 #로직다이 #AI반도체 #GPU #반도체패키징 #반도체공부